Fluxo de Concessão de Crédito – Application Scoring / Ciência de Dados – Material cedido pela PoD Academy
Categoria: Uncategorized
-
Concessão de Limite de Crédito
-
Entendendo os Comandos makemigrations e migrate no Django: Passo a Passo para Gerenciamento de Banco de Dados

Introdução
Quando trabalhamos com Django, um dos frameworks Python mais populares para desenvolvimento web, o gerenciamento de banco de dados é parte crucial da construção de aplicações robustas e escaláveis. Os comandos
makemigrationsemigratesão ferramentas essenciais para manipular o banco de dados de forma organizada, permitindo criar e atualizar tabelas sem precisar lidar diretamente com SQL. Este artigo é um guia passo a passo sobre como e quando usar esses comandos para aplicar alterações no banco de dados de maneira eficiente.
Passo a Passo dos Comandos
makemigrationsemigrate:1- Configurando o Ambiente
Antes de iniciarmos, certifique-se de que seu projeto Django está configurado e com um banco de dados conectado. O arquivo
settings.pyé onde configuramos o banco de dados. Vamos usar o exemplo com um banco SQLite:# Python DATABASES = { 'default': { 'ENGINE': 'django.db.backends.sqlite3', 'NAME': BASE_DIR / 'db.sqlite3', } }2- Criando ou Alterando um Model
Imagine que você queira criar um modelo para armazenar dados de produtos em uma aplicação de e-commerce. No arquivo
models.pyda sua app, adicione a classe do modelo:# Python from django.db import models class Produto(models.Model): nome = models.CharField(max_length=100) preco = models.DecimalField(max_digits=10, decimal_places=2) estoque = models.IntegerField() def __str__(self): return self.nome3- Gerando uma Migração com
makemigrationsAgora que temos um novo modelo, precisamos criar uma migração, que é um arquivo de controle de versão para as mudanças no banco de dados. No terminal, dentro da pasta do projeto, execute:
# Bash
python manage.py makemigrations
Esse comando cria um arquivo de migração na pasta
migrationsda sua app. Ele contém instruções para Django aplicar essas mudanças no banco de dados.4- Verificando o Arquivo de Migração
Se desejar, você pode revisar o arquivo de migração gerado. Ele fica em
nome_da_app/migrations/. Esse arquivo conterá algo como:# Python from django.db import migrations, models class Migration(migrations.Migration): initial = True dependencies = [] operations = [ migrations.CreateModel( name='Produto', fields=[ ('id', models.BigAutoField(auto_created=True, primary_key=True, serialize=False, verbose_name='ID')), ('nome', models.CharField(max_length=100)), ('preco', models.DecimalField(decimal_places=2, max_digits=10)), ('estoque', models.IntegerField()), ], ), ]5- Aplicando a Migração com
migratePara atualizar o banco de dados com a estrutura criada, utilizamos o comando
migrate:# Bash python manage.py migrateEsse comando verifica as migrações pendentes e as aplica ao banco de dados, criando ou atualizando tabelas conforme necessário.
6- Modificando um Modelo Existente
Caso deseje adicionar um campo ao modelo
Produto, por exemplo, uma descrição, basta atualizar o modelo e gerar uma nova migração.# Python class Produto(models.Model): nome = models.CharField(max_length=100) preco = models.DecimalField(max_digits=10, decimal_places=2) estoque = models.IntegerField() descricao = models.TextField(null=True, blank=True) # novo campo def __str__(self): return self.nomeEm seguida, execute
makemigrationsemigratenovamente para aplicar a mudança:# Bash python manage.py makemigrations python manage.py migrateConclusão
Os comandos
makemigrationsemigratesão fundamentais para o desenvolvimento de aplicações Django, permitindo que possamos alterar a estrutura do banco de dados sem precisar manipular SQL diretamente. Com essas ferramentas, gerenciar o ciclo de vida do banco de dados torna-se mais seguro e prático. O uso eficiente desses comandos permite a criação de sistemas que acompanham a evolução da aplicação, mantendo a integridade dos dados e facilitando futuras implementações. -
Introdução à Programação Quântica com Ket
Nesta talk, dividiremos o conteúdo em três partes principais. Começaremos com uma visão geral sobre as perspectivas da computação quântica e o que podemos esperar dessa tecnologia revolucionária. Em seguida, mergulharemos nos conceitos fundamentais da física quântica e em como eles podem ser aplicados ao processamento de dados, formando a base da computação quântica. Para encerrar, faremos uma introdução à plataforma de programação quântica Ket, que permite a qualquer programador Python desenvolver e testar aplicações quânticas.
Por conta do tempo limitado
infelizmente não me deixarão falar por três horas!não será possível nos aprofundarmos na programação quântica em si. No entanto, para quem se interessar, o canal do Grupo de Computação Quântica da UFSC no YouTube oferece um minicurso dividido em três partes, que apresenta a plataforma Ket com foco em construções específicas disponíveis para a programação quântica.Você pode acessar os slides desta talk abaixo. Também incluímos os vídeos do minicurso de Ket apresentado durante o VII Workshop de Computação Quântica da UFSC, caso queira explorar ainda mais essa fascinante área.
Minicurso: Introdução à Programação Quântica com Ket
-
Celery: Processamento Assíncrono e Escalável em Aplicações Python
Antes de começarmos a falar sobre o Celery, é importante entender como o fluxo web tradicional pode enfrentar sérios desafios de desempenho e escalabilidade ao lidar com tarefas demoradas diretamente no ciclo de solicitação-resposta.
Fluxo Web
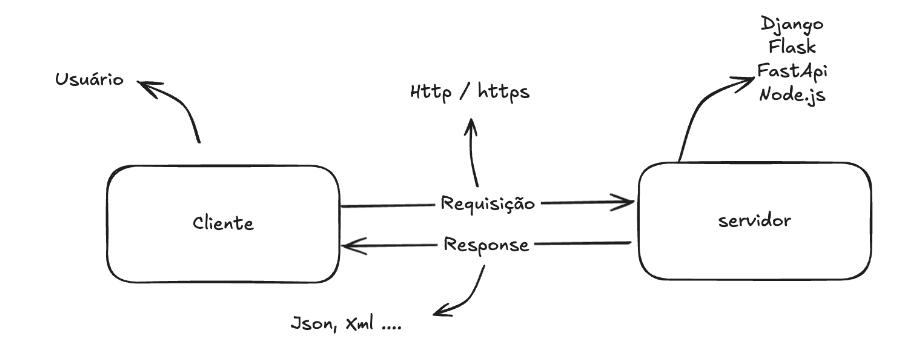
Aplicações web modernas precisam lidar com tarefas complexas que vão além de apenas processar solicitações e enviar respostas. Enviar e-mails, processar dados, gerar relatórios ou interagir com APIs externas são apenas alguns exemplos de operações que podem ser demoradas. Quando essas tarefas são executadas diretamente no fluxo de uma aplicação web, podem surgir sérios problemas de desempenho e escalabilidade.
O Problema do Fluxo Tradicional Sem Celery
1. Demora na Resposta ao Usuário
Imagine que um usuário faz uma solicitação em um sistema web para:
- Enviar um e-mail de confirmação;
- Gerar um relatório detalhado;
- Processar um grande volume de dados.
Se essas operações forem realizadas dentro do fluxo principal, o tempo de resposta do servidor aumentará significativamente, pois o sistema estará ocupado executando essas tarefas antes de responder ao usuário. O resultado é uma experiência ruim para o cliente, com longos tempos de espera.
2. Baixa Escalabilidade
Em um cenário de alta demanda, múltiplos usuários podem acessar o sistema simultaneamente. Cada solicitação que envolve tarefas demoradas irá:
- Bloquear recursos do servidor, como threads ou processos, enquanto aguarda a conclusão da tarefa.
- Aumentar a carga no servidor, tornando o sistema lento e, eventualmente, indisponível para novos usuários.
Isso cria um gargalo no sistema, tornando difícil lidar com grandes volumes de tráfego.
3. Falta de Resiliência
Se uma tarefa falhar (por exemplo, um serviço externo não responder), todo o fluxo da solicitação pode ser interrompido. Além disso:
- Não há um mecanismo fácil para repetir tarefas falhas.
- Não há como priorizar tarefas mais urgentes sobre outras.
Celery
O Celery é uma biblioteca Open Source para processamento de tarefas assíncronas em Python por meio de uma Fila (Queue). Ele permite que as tarefas sejam armazenadas por um (Broker) e processadas fora do fluxo principal da aplicação, de forma assíncrona, ou seja, em segundo plano. Com ele, podemos processar uma grande quantidade de tarefas de maneira distribuída, utilizando múltiplos servidores ou threads (workers)
1. Producer (Produtor)
O Producer é a parte do sistema responsável por enviar tarefas para o intermediário. Ele cria e define a tarefa a ser executada e a delega para ser processada em segundo plano.
Características do Producer:
- Geralmente é a sua aplicação principal (web ou backend).
- Não executa as tarefas diretamente, apenas as enfileira.
- Envia os dados necessários para que o Consumer processe a tarefa posteriormente.
Exemplo no Celery:
No Python, você define uma tarefa em sua aplicação e a chama de forma assíncrona:
from celery_app import app

# Definindo uma tarefa simples
@app.task
def send_email(recipient, subject, body):
    # Configurações do servidor de e-mail
    SMTP_SERVER = 'smtp.gmail.com'
    SMTP_PORT = 587
    SMTP_USER = 'seu_email@gmail.com'
    SMTP_PASS = 'sua_senha'

    try:
        with smtplib.SMTP(SMTP_SERVER, SMTP_PORT) as server:
            server.starttls()
            server.login(SMTP_USER, SMTP_PASS)
            message = f"Subject: {subject}\n\n{body}"
            server.sendmail(SMTP_USER, recipient, message)
        return f"E-mail enviado para {recipient} com sucesso!"
    except Exception as e:
        return f"Erro ao enviar e-mail: {str(e)}"
from my_app.tasks import send_email @app.route('/register', methods=['POST']) def register(): data = request.json if not data or 'email' not in data or 'username' not in data: return jsonify({"error": "Dados inválidos"}), 400 email = data['email'] username = data['username'] # Mock de registro no banco # Aqui, você salvaria o usuário no banco de dados (não implementado) print(f"Usuário {username} registrado com sucesso!") # Enviar e-mail de boas-vindas de forma assíncrona subject = "Bem-vindo ao nosso sistema!" body = f"Olá, {username}!\n\nObrigado por se registrar no nosso sistema!" send_email.delay(email, subject, body) return jsonify({"message": f"Usuário {username} registrado com sucesso. E-mail enviado para {email}."}), 201Aqui, o método
.delay()enfileira a tarefa, tornando a aplicação o Producer.2. Intermediário (Message Broker)
O Intermediário é o componente que age como um sistema de fila de mensagens, recebendo as tarefas enviadas pelo Producer e armazenando-as até que sejam consumidas pelos Consumers.
Características do Intermediário:
- Atua como um “ponto central” para comunicação entre Producer e Consumer.
- Suporta múltiplas mensagens e filas simultaneamente.
- Não processa as tarefas, apenas organiza e entrega as mensagens.
Exemplos de Intermediários Comuns:
- Redis: Um banco de dados em memória que funciona como message broker leve e rápido.
- RabbitMQ: Um sistema avançado de filas de mensagens com suporte a funcionalidades como roteamento de mensagens e troca de tópicos.
- Amazon SQS: Um serviço de fila na nuvem da AWS.
Configuração no Celery:
Ao configurar o Celery, você define o intermediário (broker) no arquivo de configuração:
from celery import Celery

# Criando a instância do app Celery
app = Celery(
    'my_app',  # Nome do app
    broker='redis://localhost:6379/0',  # URL do intermediário (Redis)
    backend='redis://localhost:6379/0'  # URL para backend de resultados (opcional)
)

# Configuração adicional (opcional)
app.conf.update(
    task_serializer='json',
    result_serializer='json',
    accept_content=['json']
)
3. Consumer (Consumidor)
O Consumer é o componente que recebe as tarefas do intermediário e as executa. No Celery, o Consumer é representado pelos Workers.
Características do Consumer:
- Um ou mais workers podem estar rodando simultaneamente.
- Cada worker escuta as filas no intermediário, busca as tarefas e as processa.
- Executa o código Python correspondente à tarefa.
Comandos no Celery:
Para iniciar um Consumer (worker) no Celery, você usa o comando:
celery -A my_app worker --loglevel=infoNeste exemplo:
-A my_app: Especifica o nome da aplicação Celery.worker: Inicia o processo de consumo.--loglevel=info: Define o nível de detalhe do log para monitorar o worker.
Resumo do Fluxo
- Producer: Envia a tarefa para o intermediário (ex.: enviar um e-mail).
- Intermediário: Armazena a tarefa em uma fila e aguarda que um Consumer a consuma.
- Consumer: O worker busca a tarefa no intermediário, executa o código Python necessário e finaliza a tarefa.
Como o Celery Resolve Esses Problemas ?
1. Resposta Imediata ao Usuário
Quando o Celery é integrado ao fluxo, a aplicação web simplesmente enfileira a tarefa e responde ao usuário imediatamente. Por exemplo:
- O usuário solicita um relatório;
- O servidor enfileira a tarefa no Celery e retorna uma mensagem como: “Relatório em processamento, você receberá uma notificação quando estiver pronto”;
- A tarefa é executada em segundo plano e o usuário não precisa esperar.
Isso melhora drasticamente a experiência do usuário.
2. Escalabilidade Melhorada
Com o Celery, tarefas em background são gerenciadas por workers, que podem ser escalados horizontalmente conforme necessário. Quando a carga aumenta, basta adicionar mais workers para processar as filas.
Além disso, como as tarefas não bloqueiam o fluxo principal, o servidor pode lidar com muito mais solicitações simultâneas.
3. Resiliência e Controle
O Celery oferece mecanismos robustos para lidar com falhas e gerenciar tarefas:
- Retry Automático: Se uma tarefa falhar, o Celery pode executa-la de novo automaticamente após um período definido.
- Prioridade de Tarefas: Tarefas mais críticas podem ser enfileiradas com prioridade maior.
- Monitoramento: Ferramentas como o Celery Flower permitem acompanhar o status de tarefas em tempo real.
Fluxo com Celery: Um Exemplo Prático
Sem Celery:
- O usuário faz uma solicitação para enviar um e-mail.
- O servidor processa a solicitação e envia o e-mail diretamente.
- O tempo de resposta ao usuário é atrasado pelo tempo necessário para enviar o e-mail.
Com Celery:
- O usuário faz a mesma solicitação.
- O servidor enfileira a tarefa no Celery e responde ao usuário imediatamente.
- Um worker do Celery processa a tarefa em segundo plano e envia o e-mail.
O que é o Celery Beat?
O Celery Beat é um agendador de tarefas para o Celery. Ele permite que você configure tarefas periódicas para serem executadas em horários ou intervalos definidos, como um cron job, mas integrado diretamente à sua aplicação Celery.
Principais Funcionalidades
- Agendamento de Tarefas Recorrentes: Crie tarefas que são executadas automaticamente em horários pré-definidos (diariamente, semanalmente, etc.).
- Persistência: Os agendamentos podem ser armazenados em um banco de dados, permitindo que você mantenha configurações mesmo após reiniciar o serviço.
- Flexibilidade: Compatível com os métodos de agendamento do Celery, como intervalos, horários específicos e configurações baseadas em crontab.
Exemplo de Configuração
No seu arquivo de configuração do Celery, você pode definir tarefas periódicas usando o Celery Beat:
from celery import Celery
from celery.schedules import crontab

app = Celery('my_app', broker='redis://localhost:6379/0')

app.conf.beat_schedule = {
    'send-email-daily': {
        'task': 'my_app.tasks.send_email',
        'schedule': crontab(hour=8, minute=0),  # Todos os dias às 8h
        'args': ('example@example.com',),
    },
}
Após configurar, é necessário rodar o scheduler com o comando:
celery -A my_app beatO que é o Celery Flower?
O Celery Flower é uma ferramenta de monitoramento baseada em web para o Celery. Ele fornece uma interface amigável para acompanhar o estado das tarefas, a fila de mensagens e os workers em tempo real.
Principais Funcionalidades
- Monitoramento de Workers: Veja quais workers estão ativos, seu status e quantas tarefas estão processando.
- Estado de Tarefas: Acompanhe tarefas pendentes, em execução e concluídas.
- Histórico: Consulte o histórico de execução de tarefas, incluindo informações sobre falhas.
- Gerenciamento de Filas: Monitore e manipule mensagens nas filas.
Como Usar o Flower
Para instalar o Flower, basta usar o pip:
pip install flowerDepois de instalado, você pode iniciá-lo com o comando:
celery -A my_app flowerPor padrão, o Flower estará disponível em http://localhost:5555. Ele exibirá um painel com informações detalhadas sobre o funcionamento do seu sistema Celery.
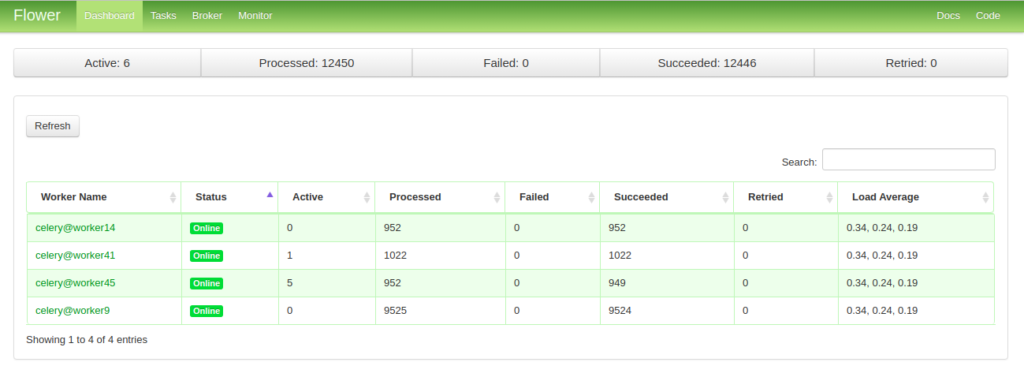
Aqui você pode encontrar um exemplo prático para rodar uma aplicação com o celery, acesse o repositório no GitHub:
-
Dark Data, desafios e potenciais em analytics
O conceito de dark data ou “dados obscuros” se refere a informações que são coletadas, armazenadas e processadas por organizações, mas que não são utilizadas de forma ativa para gerar insights ou agregar valor. São dados que muitas vezes ficam “escondidos” e não são analisados, não por falta de coleta, mas pela falta de ferramentas, processos ou consciência para extraí-los e utilizá-los. O fenômeno do dark data é um dos maiores desafios no cenário atual de gestão de dados, uma vez que muitas organizações lidam com enormes volumes de informações que acabam sendo negligenciadas.
Atualmente, o mundo está imerso em um mar de dados. A cada minuto, bilhões de informações são geradas em plataformas como redes sociais, e-mails, sites de vídeo e outras fontes digitais. Por exemplo, são enviados mais de 231 milhões de e-mails, compartilhadas 66 mil fotos no Instagram e assistidos mais de 3 milhões de vídeos no YouTube, todos os minutos. Cada uma dessas interações gera dados que, muitas vezes, não são analisados ou usados de forma eficiente. Esse vasto oceano de informações pode ser visto como uma grande oportunidade para negócios e organizações que souberem como minerar e explorar esses dados de maneira estratégica.
Dark data é o termo que define os dados que são coletados, mas não utilizados de forma eficaz. Esses dados podem ser de diversas fontes, como logs de navegação, e-mails antigos, imagens ou vídeos que nunca são acessados novamente, ou informações que são armazenadas de maneira desorganizada e esquecida ao longo do tempo. Um exemplo comum é o histórico de navegação da internet, que contém dados que, embora acumulados, não são analisados. Da mesma forma, muitas empresas mantêm uma enorme quantidade de dados que, devido à falta de uma estratégia de governança, não são acessados nem analisados. De acordo com uma pesquisa da IBM com 1600 empresas, 90% relataram que mais de 50% de seus dados armazenados são dark data, um número que ilustra o imenso potencial não explorado que se perde devido à falta de ação.
Os dados obscuros podem vir em diferentes formatos, como arquivos antigos de computador, dados de formulários não utilizados, registros de interações (como chamadas telefônicas e e-mails antigos) e até mesmo informações de sensores que não foram analisadas ou aproveitadas. Esses dados podem estar espalhados em diversos locais e, sem um processo de organização ou governança, permanecem inutilizados. Por exemplo, quantas vezes um sensor de porta automática registrou sua abertura, mas esses dados não são utilizados de forma útil? Esse é apenas um exemplo de como os dados, coletados mas não analisados, ficam perdidos.
A principal razão pela qual os dark data se acumulam é a ideia equivocada de que armazenar todos os dados possíveis é vantajoso. Embora o armazenamento de dados seja barato e acessível, especialmente com o uso da nuvem, muitas organizações não têm ferramentas ou processos adequados para organizar, integrar e analisar esses dados. A análise de dados estruturados, como planilhas e bancos de dados relacionais, é mais fácil e amplamente utilizada, mas quando se trata de dados não estruturados, como imagens, vídeos, PDFs ou até mesmo textos em e-mails, o processo de extração de insights torna-se muito mais complexo.
Além disso, muitos dados armazenados são de baixa qualidade, incompletos ou mal documentados. Isso torna ainda mais difícil para as organizações acessarem e utilizarem esses dados de maneira eficaz. A falta de uma governança de dados adequada, ou de políticas claras sobre como armazenar, proteger e acessar os dados, é um dos maiores entraves para a exploração de dark data. Muitas vezes, esses dados são esquecidos ou negligenciados, simplesmente porque as equipes não sabem onde eles estão ou como podem ser usados.
Existem muitos riscos associados ao armazenamento de dark data que não são utilizados. Além do desperdício de recursos e custos com armazenamento de dados que não geram valor, há o risco de segurança e compliance. Dados sensíveis que não estão devidamente protegidos podem ser acessados por pessoas não autorizadas, o que pode resultar em violação de privacidade e potenciais multas e penalidades.
Além disso, o não uso desses dados pode significar oportunidades de negócio perdidas. Os dados não analisados contêm insights valiosos que podem melhorar a tomada de decisões, otimizar processos e até gerar inovações. Ao deixar esses dados acumularem sem serem aproveitados, as organizações perdem a chance de se tornar mais eficientes e competitivas.
Para lidar com o desafio do dark data, as organizações devem adotar uma abordagem proativa. É preciso implementar políticas de governança de dados que garantam a organização, integridade e acessibilidade dos dados armazenados. Além disso, as empresas precisam investir em ferramentas e tecnologias que possam analisar dados não estruturados, como inteligência artificial, aprendizado de máquina e outras técnicas avançadas de análise de dados.
Uma boa governança de dados é crucial para garantir que os dados sejam armazenados de forma adequada, com a documentação correta e rotulagem dos metadados, o que facilita sua utilização futura. É necessário também treinar as equipes para que entendam a importância de organizar e analisar todos os dados disponíveis, não apenas aqueles mais fáceis de acessar.
Quando bem geridos e analisados, os dark data têm um imenso potencial para gerar valor. As organizações que conseguem iluminar seus dados obscuros podem obter insights valiosos que os ajudam a tomar decisões mais informadas, melhorar a experiência do cliente, identificar novas oportunidades de mercado e, no geral, se tornar mais competitivas.
Empresas de diversos setores, como financeiro, saúde e varejo, estão começando a perceber o valor dos dados não estruturados e estão adotando estratégias para extrair insights deles. Um exemplo disso é o uso de dados não estruturados no setor de saúde, como gravações de conversas entre médicos e pacientes ou anotações de prontuários, para melhorar os cuidados médicos e personalizar o tratamento.
O gerenciamento eficiente de dark data é um dos maiores desafios e, ao mesmo tempo, uma das maiores oportunidades no campo de analytics. As empresas que conseguirem identificar e analisar seus dados obscuros não apenas reduzirão custos e riscos, mas também poderão desbloquear insights que transformarão suas operações e estratégias. Incorporar os dark data nas práticas de big data analytics permitirá que as organizações se mantenham à frente da concorrência em um mundo cada vez mais orientado por dados.
Links fontes
https://www.ibm.com/topics/dark-data
https://www.youtube.com/watch?v=Ql331AJYmVI
https://link.springer.com/article/10.1007/s13347-019-00346-x
https://dictionary.cambridge.org/dictionary/english/data
https://localiq.com/blog/what-happens-in-an-internet-minute/
https://fpt-is.com/en/insights/dark-data-unveiling-the-darkness/
https://askwonder.com/research/case-studies-dark-data-gbm1p079uRecomendações de Conteúdo
Documentário “What Facebook Has Done To Us”
Canais no youtube
Cleo Abram – https://www.youtube.com/@CleoAbram
IBM – https://www.youtube.com/@IBMTechnology/videos3
Blue 1 Brown – https://www.youtube.com/@3blue1brown

